Дашборд Server Stats
Дашборд Server Stats обеспечивает верхнеуровневый мониторинг метрик загрузки серверов во всей вашей стриминговой инфраструктуре.
Его обзорная часть похожа на стандартные инструменты мониторинга серверов, но важно то, что он уже включен в сервис и вам не надо следить за дополнительными агентами.
Самые перегруженные серверы
Эта панель отображает серверы с наивысшим использованием ресурсов по основным измеряемым показателям.

Отображаемая информация:
- Наверх поднимаются серверы с максимальной нагрузкой хотя бы одному параметру.
- Распределение нагрузки во времени. Рекомендуется менять временной диапазон, сужение его до часов и минут может поднять наверх сервера со свежими проблемами.
Сценарии использования:
- Выбрать в дешборде последние 2-3 часа, увидеть что есть сервера с красной индикацией, приступить к устранению проблемы
- Выбрать в дешборде последние 7 дней, увидеть что есть периодические всплески нагрузки вплоть до красных. Установить источник периодического роста и если его не должно быть, устранить проблему.
- Выбрать в дешборде последние 30 дней, увидеть планомерный рост нагрузки, начать планировать расширение инфраструктуры
Пример перегруженного сервиса

На этом сервисе ситуация с CPU и загрузкой вся в желтой зоне. Можно считать это умелой утилизацией серверов, потому что признаков полки на графике CPU нет, однако никакой дополнителной нагрузки эти сервера не перенесут.
Загрузка CPU и виртуальной машины
Две следующих панели дают обзорную картину загрузки центрального процессора и виртуальной машины. Это разные величины, нельзя ориентироваться только по одной.
Частая ошибка системных администраторов - принимать решения без знаний о работе виртуальной машины и жаловаться на рост CPU, не учитывая шедулер.


Загрузка процессора в 80% не является критической, хотя и повышенной. Работоспособность стримингового сервера необходимо оценивать по загрузке шедулера, это более достоверная метрика. Работа виртуальной машины может подразумевать высокую загрузку процессора, в особых случаях является нормой 100% полная загрузка нескольких ядер процессора.
Важно: нельзя экстраполировать загрузку процессора, добавив несколько потоков и рассчитывать на линейный рост дальше. Внутренние механизмы, позволяющие масштабировать стриминговый сервер на тысячи одновременных потоков стоят определенных ресурсов, поэтому рост будет нелинейный.ы
На этом графике и дальше графики разделены по версиям. Очень удобно отслеживать: действительно ли была деградация производительности, или это лишь иллюзия.
Пример критической нагрузки


На этих двух графиках видно, что CPU на пределе (этот сервис уже упоминался выше) и возможно упирается в полку, т.е. не справляется, но по графику шедулера видно, что полки нет, просто сервер на пределе. Хотя дальше будет видно, что диски у него не справляются.
Настройте алерты: Чтобы не пропустить критическую загрузку серверов, настройте алерты на высокую загрузку CPU и алерты на загрузку планировщика. Они предупредят вас до того, как сервер перестанет справляться с нагрузкой.
Использование оперативной памяти
Мониторинг использования RAM на серверах.

Показывается общее использование памяти, ориентироваться надо на этот график.
Норма - стабильное
На графике нет индикации использования swap по одной простой причине: на стриминговом сервере своп должен быть выключен, он не нужен ни в каком сценарии, зато может привести к тому, что вместо аварийного отключения, система уйдет в отказ и вместо нескольких минут простоя будут десятки минут.
Настройте алерт: Настройте алерт на нехватку оперативной памяти, чтобы получать уведомления при приближении к лимиту RAM и вовремя принимать меры.
Ошибки записи на диск
Отслеживание ошибок записи на диск.

Отображаемые метрики:
- Сгруппированные записи на диск
- Провалившиеся попытки записи
Когда хранилище начинает не успевать записывать (это нормальное поведение для сетевых стораджей, которые очень часто не способны неделями выдавать постоянно стабильную и предсказуемую скорость записи), сначала медиасервер начинает группировать соседние записи. Каждая такая группировка отражается на графике Collapsed writes и является тревожной ситуацией. Такого не должно происходить, но это пока ещё не проблема.
Как правило после длительного игнорирования collapsed writes можно наблюдать отказы в записи: failed writes. Медиасервер не может вечно хранить сегменты в очереди на запись, он их хранит ровно столько, сколько они доступны в лайве на просмотр, поэтому когда окно проигрывания уходит, а запись не произошла, видео потеряно безвозвратно.
Это уже серьезный отказ сервиса.
Сценарии использования:
- Обнаруживать отказывающее оборудование хранилища
- Выявлять проблемы файловой системы
- Планировать замену дисков
- Мониторить надежность хранилища
Настройте алерт: Алерт на проблемы с дисками критически важен для серверов с DVR. Он предупредит вас при появлении collapsed writes до того, как начнутся failed writes с потерей видео.
Утилизация диска
Мониторинг скорости работы дисков позволяет увидеть потенциальные проблемы на раздельных дисках.
В этот раздел имеет смысл попадать, если есть индикация ошибок записи или чтения с диска. В остальных случаях этот раздел носит характер ознакомительный, посмотреть раз в месяц, что тут никаких аномалий.
Процент загрузки диска

В норме тут должно быть не больше 80% Отдельные всплески допустимы, ничего страшного, если они не приводят к ошибкам работы сервиса.
Заполнение диска

Должно быть стабильно около предельного. 98% - это норма, если ваши хранилища используют ext4. Если вы решили воспользоваться btrfs, то возможен отказ сервиса уже на 55%, но мы вам помочь уже не сможем.
Скорость записи на диск

Одной нормы нет, она для шпинделя и NVME отличается на несколько порядков. Интересен резкий скачок или полка.
Скорость чтения с диска

Аналогично предыдущему: единой нормы нет. Стоит обращать внимание на резкие изменения, а так же на тренд изменения в разрезе месяцев.
Статус дисков DVR RAID (только для серверов с включённым DVR RAID)

По каждому диску, входящему в RAID для DVR на этом сервере, показывается состояние: активен (исправен) или деградирован (неисправен или отсутствует).
Панель показывает данные только если для DVR включён RAID. Неисправный или отсутствующий диск означает, что массив деградирован: избыточность снижена, и при следующем отказе возможна потеря архива записей. Это срочная задача на обслуживание — замените или восстановите диск до второго отказа.
Пример неудачного выбора дисков


По графикам выше можно сделать следующие выводы:
- Диски куплены очень большие и впустую, их не получается забить данными
- Некоторые диски перегружены записью. Возможно имеет смысл обратиться в поддержку за помощью по поиску стратегии более равномерной нагрузки на диски.
- Flussonic RAID справляется с защитой соседних дисков от перегрузки. Несмотря на один сбойный диск, остальные с работой справляются.
Потоки и клиенты
Мониторинг активных потоков и подключенных клиентов. График обзорный, более детальная картина на соседних дешбордах.
Количество потоков

Каждая линия — один статус потока:
- Зелёная, streams_running — поток работает, вход получает данные.
- Синяя, streams_idle — поток не работает, и это штатно: поток по запросу без зрителей, поток без входов или вход публикации без вещателя. Делать ничего не нужно.
- Жёлтая, streams_waiting — поток запускается или ждёт первых кадров. Состояние переходное: если поток задерживается в нём дольше таймаута входа, он переходит в ошибку.
- Красная, streams_error — поток не работает из-за ошибки.
Статус idle присылают не все серверы. У сервера, который его не присылает, синей линии нет.
Рекомендуется мониторить при апгрейдах и следить за тем, что бы картина после апгрейда не менялась.
Количество клиентов

Рекомендуется мониторить при апгрейдах и совмещать с работой балансировщика, убедиться в том, что количество выходит на предыдущий до апгрейда уровень.
Минуты, в которые сервер не прислал число клиентов, пропускаются, а не рисуются нулём.
Ретроспектива за 3 месяца

Видно, что на этом сервере за 3 месяца количество стримов резко не менялось, их плавно переносят на новые сервера.
Сетевой трафик
Мониторинг входящего и исходящего сетевого трафика в битах в секунду. Ось Grafana сама переводит в Мбит/с и Гбит/с.
Входящий медиатрафик

Дает представление о том, сколько входящего трафика видит сам медиа сервер. Иногда может радикально отличаться от системного графика, если есть захват с ASI, SDI или loopback.
Входящий системный трафик
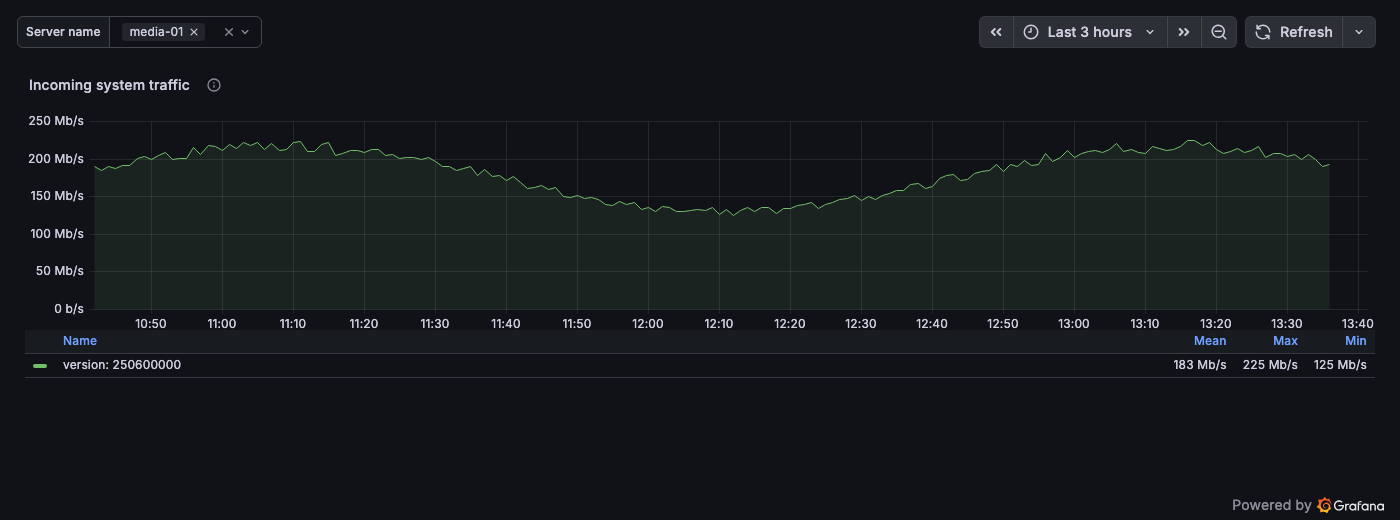
Сколько трафика заходит в операционную систему. Может ощутимо отличаться и быть причиной отказов сети, если есть ещё потребители трафика кроме медиасервера.
Исходящий медиатрафик

Исходящий системный трафик

Состояние GPU
Мониторинг нагрузки и состояния видеокарты для транскодирования и видеоаналитики.

График показывает общую утилизацию карты. Блоки кодирования и декодирования нагружаются неравномерно, поэтому умеренное значение здесь не означает, что запас есть: NVENC может быть занят полностью при спокойном общем графике. На вопрос «карта работает или простаивает» график отвечает; для разбора нехватки ресурсов смотрите занятость карт ниже.

Охлаждение GPU обязательно. При высокой температуре карта начинает вести себя непредсказуемо, и её поведение плохо диагностируется: троттлинг, срывы сессий кодирования, отказы в выдаче карты. Всё это выглядит как проблема потока, драйвера или настроек, и до температуры доходят в последнюю очередь. Если график подбирается к 90 градусам, начинайте разбор отсюда.
Инвентарь установленных карт
Три таблицы GPU park by compute capability, by architecture и by model показывают, какие видеокарты NVIDIA стоят на выбранных серверах.
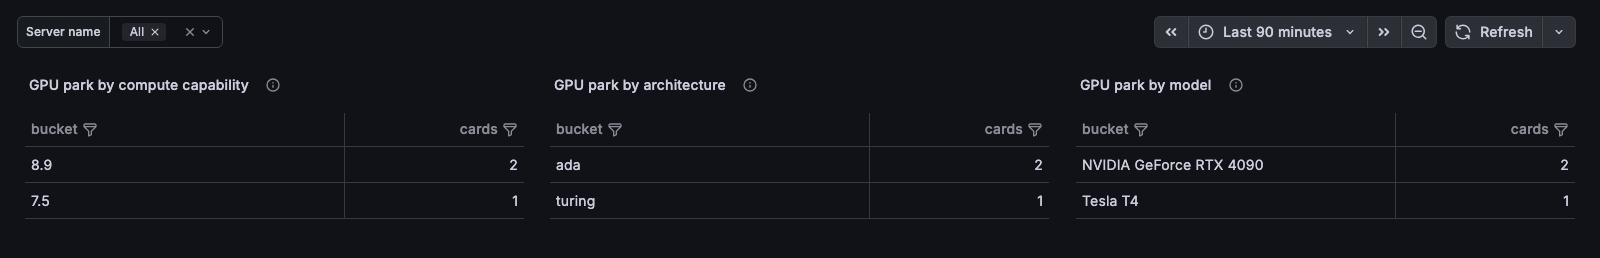
В каждой таблице две колонки: bucket — значение, по которому свёрнут парк, и cards — сколько карт с этим значением стоит на выбранных серверах.
На скриншоте это один и тот же парк из трёх карт, показанный тремя способами: по compute capability — две карты 8.9 и одна 7.5; по архитектуре — две ada и одна turing; по модели — две NVIDIA GeForce RTX 4090 и одна Tesla T4. Суммы карт во всех трёх таблицах поэтому совпадают.
Объединить их в одну таблицу нельзя: сервер присылает три независимые свёртки и не присылает связь между ними. На скриншоте связь угадывается по числам, но это совпадение маленького парка — как только моделей станет больше, сопоставить строки будет нечем. Вывод «RTX 4090 — это ada и 8.9» делает человек, данные его не содержат.
Решающая таблица — compute capability: матрицы поддержки CUDA и NVENC написаны в терминах sm_XX, а не в названиях поколений. Архитектура и модель нужны для разговора с человеком, а не для ответа на вопрос «поддерживаем ли мы этот парк».
Парк берётся из последнего отчёта каждого сервера, а не суммируется за интервал: инвентарь приходит в каждом отчёте, и суммирование умножило бы число карт на количество отчётов.
Пустые таблицы означают, что на выбранных серверах карт нет. Сервер более старой версии, которая эту статистику про видеокарты не сообщает, в таблицах не появляется вообще — это разные вещи. Если сервер отсутствует, а карты в нём есть, проверьте его версию.
Драйвер и CUDA
Таблица NVIDIA driver and CUDA показывает версии драйвера и CUDA на каждом сервере с картами и число установленных карт.
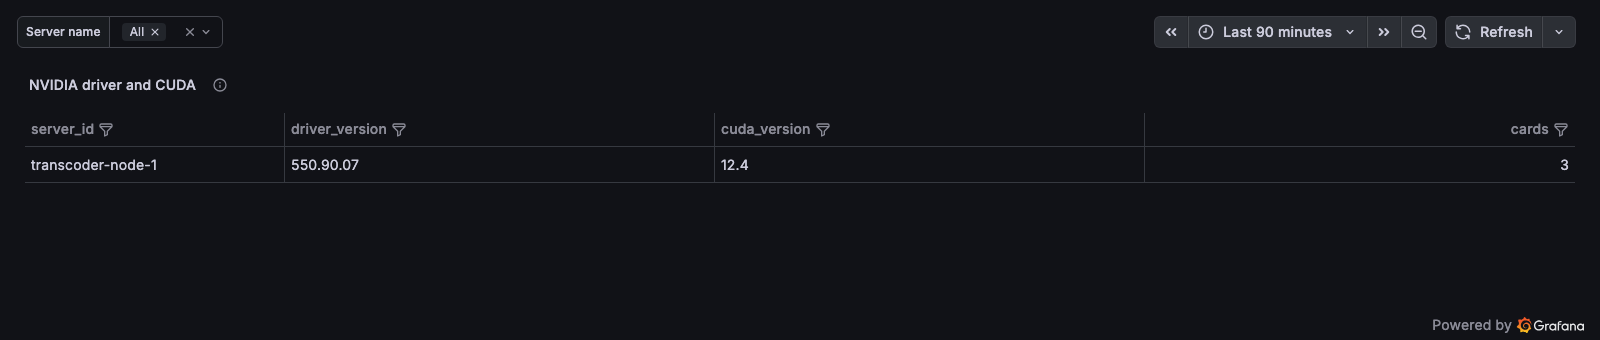
Версия драйвера определяет, какие кодеки и режимы кодирования доступны на карте: матрицы поддержки NVIDIA написаны в терминах версии драйвера и CUDA. Сюда смотрят, когда планируют обновление драйвера на парке и когда разбираются, почему кодек или пресет не работает на одном сервере и работает на другом.
Занятость карт
График Cards held vs NVENC sessions показывает по каждой карте две величины: сколько конвейеров транскодера её держат и сколько сессий NVENC на ней видит драйвер по всем процессам машины.
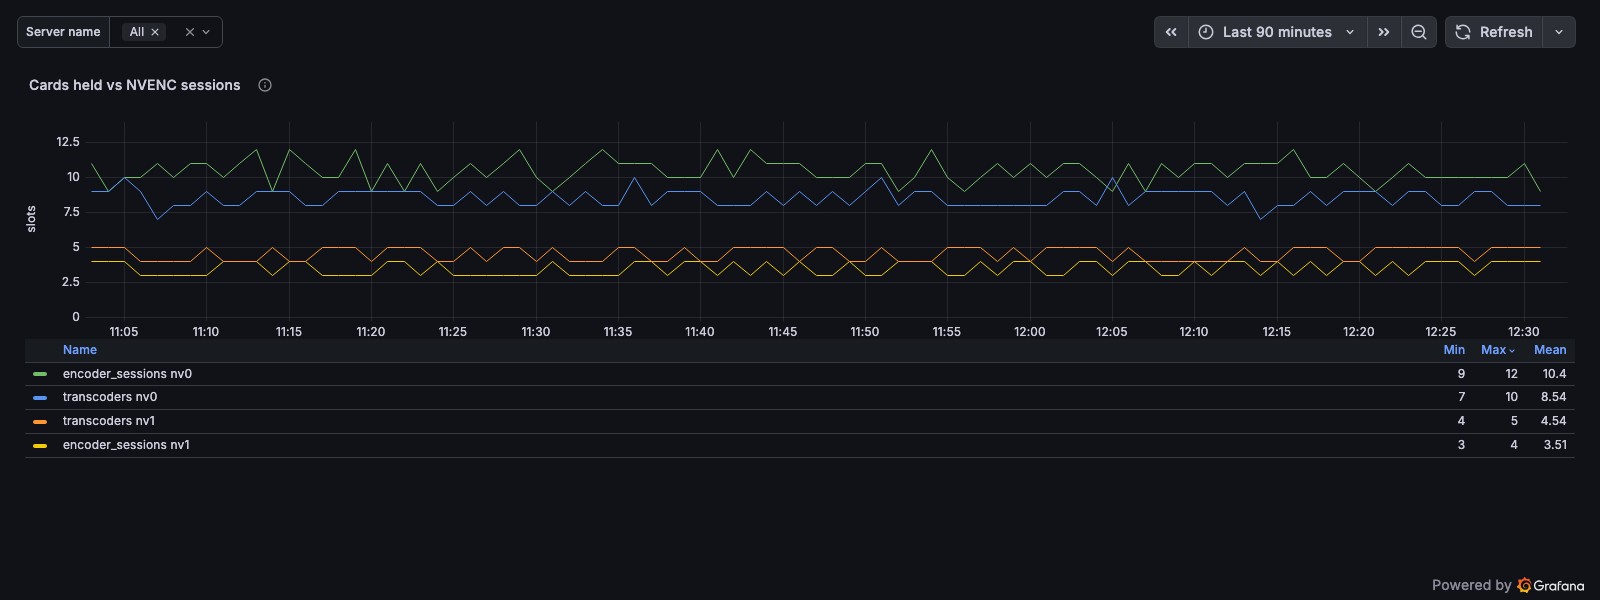
Они расходятся в обе стороны, и каждое направление означает своё:
- encoder_sessions выше transcoders — на карте кодирует кто-то ещё, помимо Flussonic;
- transcoders выше encoder_sessions — часть потоков держит карту, но прямо сейчас не кодирует.
На картах с ограничением на число одновременных сессий NVENC плотность каналов упирается в него раньше, чем в вычислительные блоки. На таком парке именно эта пара объясняет карантины по причине отказа в сессии кодирования: encoder_sessions упирается в потолок, а acquire_failures на графике ниже начинает расти.
Оборот карт
График Card turnover показывает за интервал: сколько раз карты брали, сколько раз в выдаче отказали и сколько раз карта уходила из выбора.
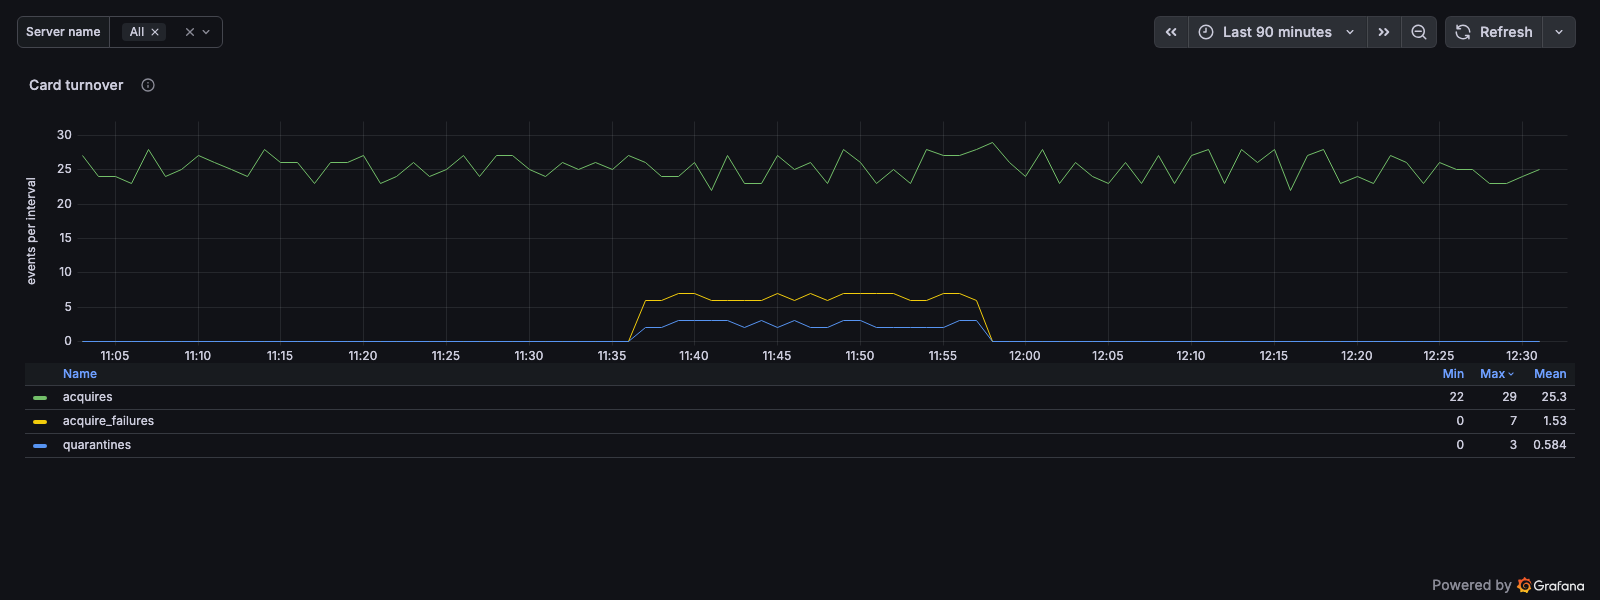
- acquires — графики утилизации выше оборот не помнят: две карты, занятые всю ночь, и потоки, хватающие карту тридцать раз в час, выглядят на них одинаково;
- acquire_failures — спрос, который карты не покрыли. Растёт при неизменной занятости, потому что отказанные потоки на карту так и не попали;
- quarantines — карту вывели из выбора: не создался контекст CUDA, отказано в сессии кодирования или декодирования.
Потоки по картам
Таблица Streams per card показывает, сколько потоков аккаунта сидело на каждой карте за интервал.
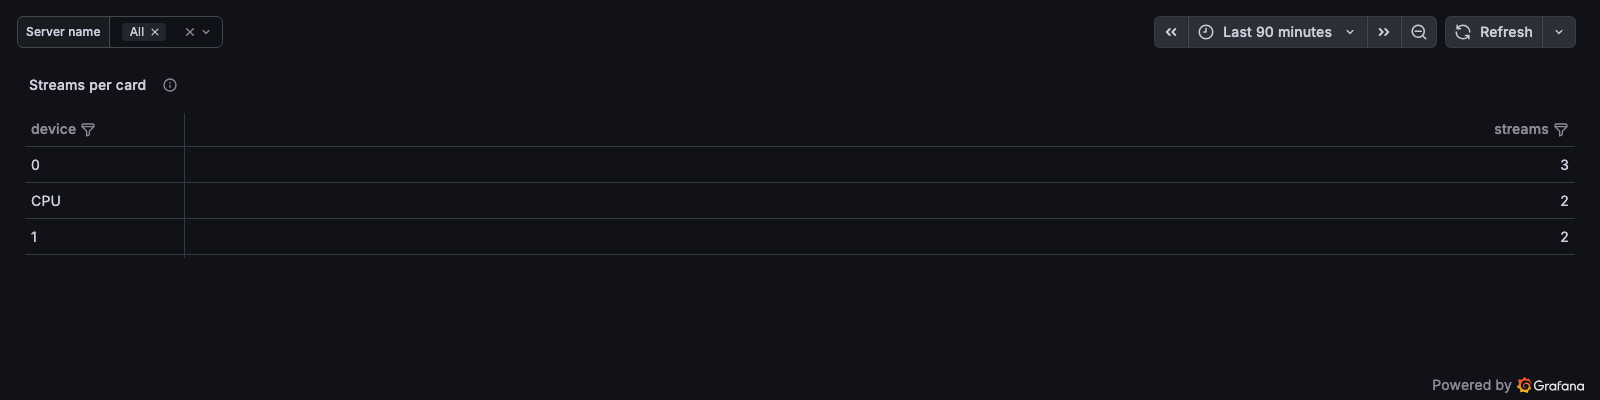
Это то, на что живая выдача сервера не отвечает задним числом: какие каналы были на карте, которая ушла в карантин ночью.
Категории те же, что в инвентаре транскодеров:
- число — индекс карты по драйверу;
- CPU — поток без карты вовсе;
- n/a — поток на сервере, который это поле не присылает: была под ним карта или нет, неизвестно.
Считается тем же способом, что инвентарь на дашборде транскодера, поэтому две таблицы не могут разойтись.
Транскодирование файлов VOD
Свёрнутый ряд VOD transcoding (whole installation) показывает, что делает транскодирование файлов: сколько заданий брокер довёл до конца, сколько отказов и сколько медиа при этом перекодировано.
Ряд отвечает по всей инсталляции и не зависит от выбора сервера в шапке дашборда. Транскодированием файлов занимается процесс с центральной ролью, и цифры каждого такого узла — лишь его доля работы. Осмысленна только их сумма по инсталляции, её ряд и показывает.
Если центральной роли в инсталляции нет вовсе, панели показывают No data, а не нули. Это разные ответы: ноль означает «заданий не было», No data — «здесь это не измеряется».
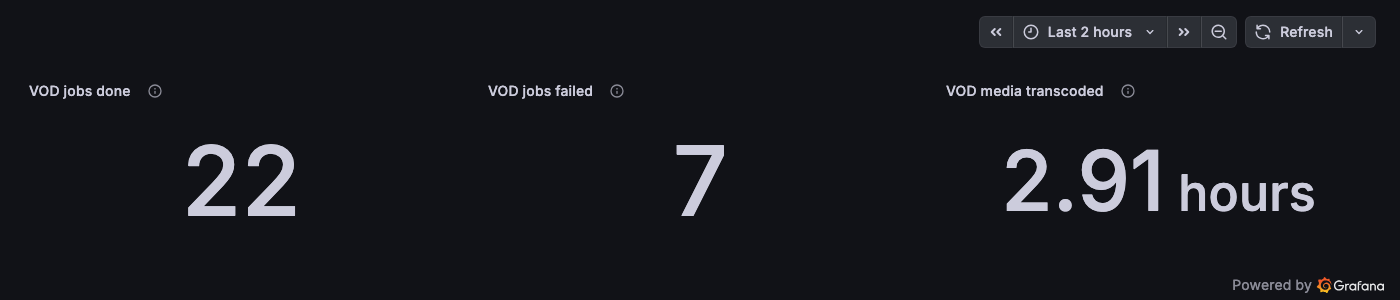
Три плитки — итог за выбранный интервал:
- VOD jobs done — задания, дошедшие до конца. Считается задание, а не попытка исполнителя: задание, которое переигрывали трижды и довели до конца, посчитано один раз;
- VOD jobs failed — отказы, которые брокер не переигрывает: терминальная ошибка входа или плана, падение, исчерпанные попытки, замолчавший исполнитель. Переигранная попытка, отмена и переполненная очередь отказами не считаются;
- VOD media transcoded — длительность входа сделанных заданий. Это длительность исходника, а не размер выхода: лесенка из трёх качеств считает исходник один раз.
Исходы заданий во времени
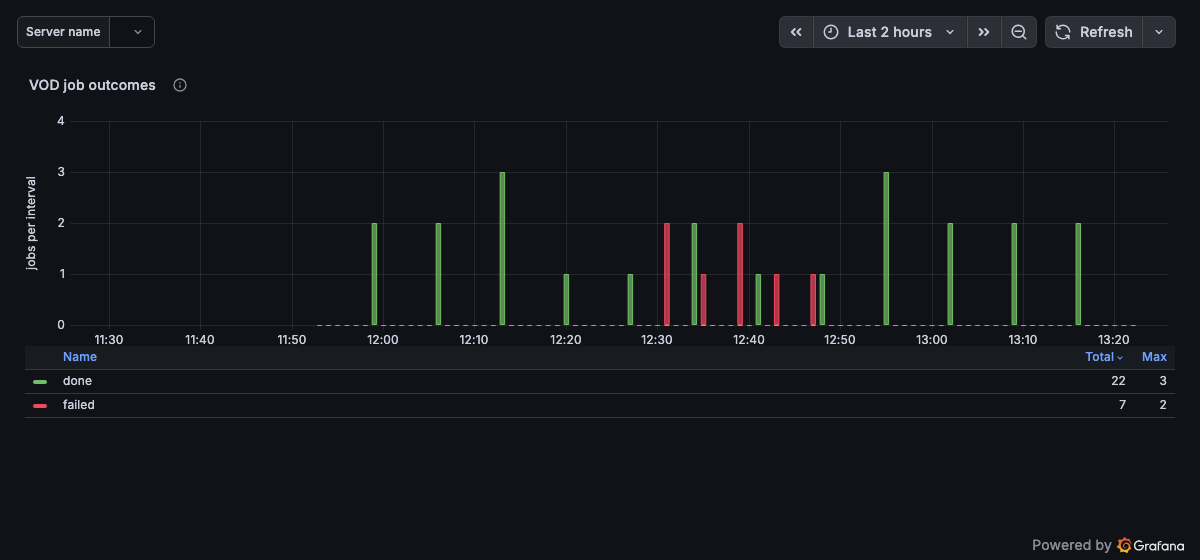
Тот же счёт, разложенный по интервалам. Считается за интервал, а не в секунду: даже нагруженная инсталляция закрывает единицы заданий в минуту, и ставка в секунду выродилась бы в ноль.
Как читать:
- полоса отказов, начавшаяся в конкретный момент, — это изменение на стороне входа или сломанный исполнитель;
- отказы, размазанные ровно по всему интервалу, — это обычно сами файлы;
- отказы при нулевом счёте сделанных — не проходит ничего, начинать разбор надо с исполнителей.
Кода ошибки телеметрия не несёт. Чтобы узнать причину конкретного отказа, откройте задание в реестре брокера.
Объём медиа во времени
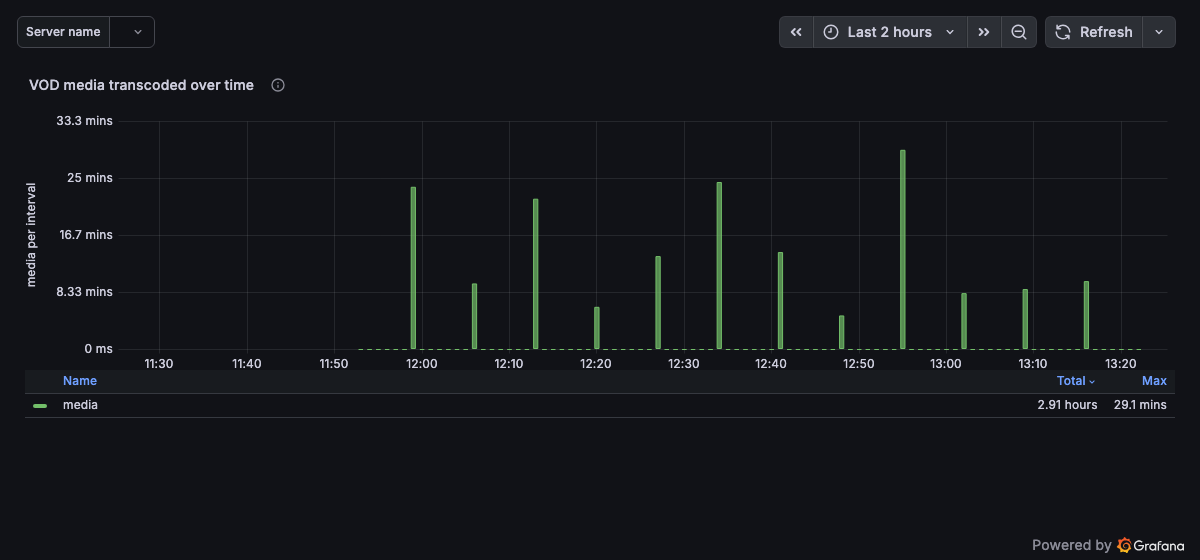
Сколько медиа перекодировано в каждом интервале. Читается рядом с исходами: если объём падает, а число заданий держится, значит файлы стали короче, а не транскодер замедлился.
Первый интервал после перезапуска узла — базовый, он отчитывается нулями. На длинном диапазоне это незаметно, на коротком — один интервал не попадает в итог.
Выгрузка архива
Оператор выделяет отрезок на ленте архива и скачивает его файлом MP4. Раздел показывает, сколько архива сервер отдал таким образом и не мешают ли этому отказы.
График Archive handed out as files показывает объём отданных файлов за интервал.
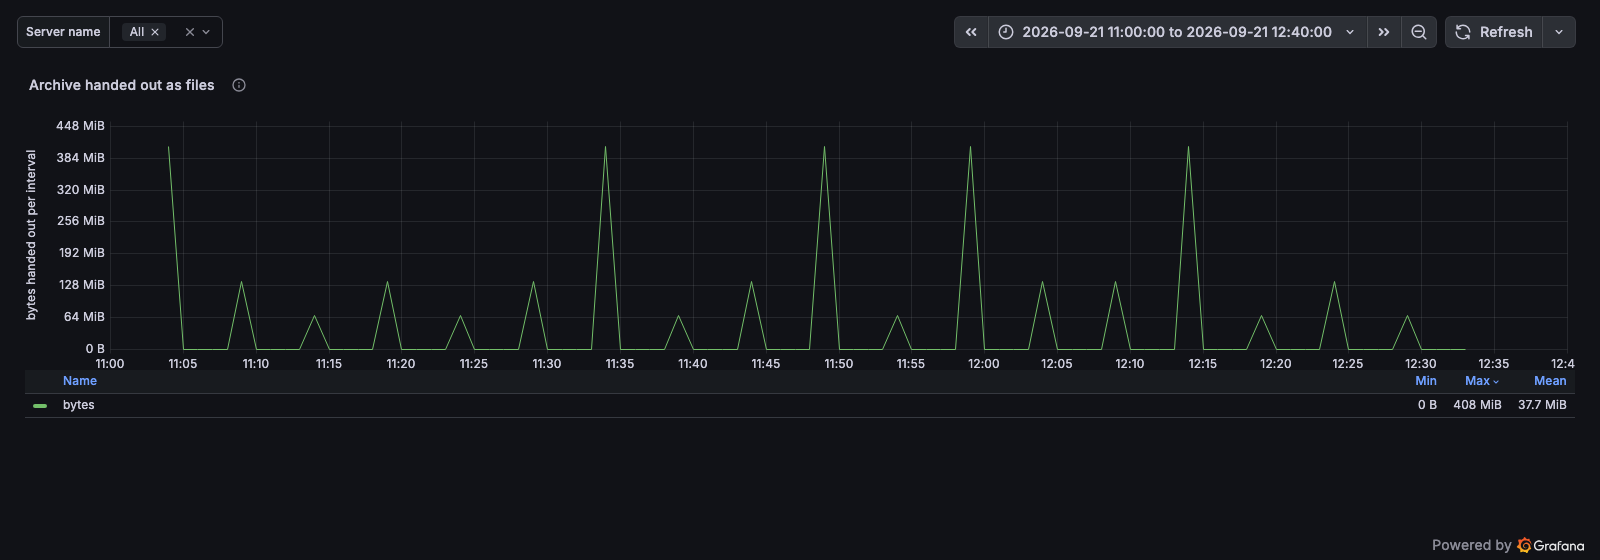
Учитывается размер файла после склейки пропусков и обрезки хвоста, а не ширина выделения: из двухчасового отрезка, в котором записано двадцать минут, сервер отдаёт только эти двадцать минут записи. Запрос заголовков, которым плеер проверяет отрезок перед скачиванием, не учитывается — считаются только отданные файлы.
График Exports refused by the node показывает отказы, за которые отвечает сам сервер: нет свободных слотов выгрузки либо сервер ответил кодом 5xx.
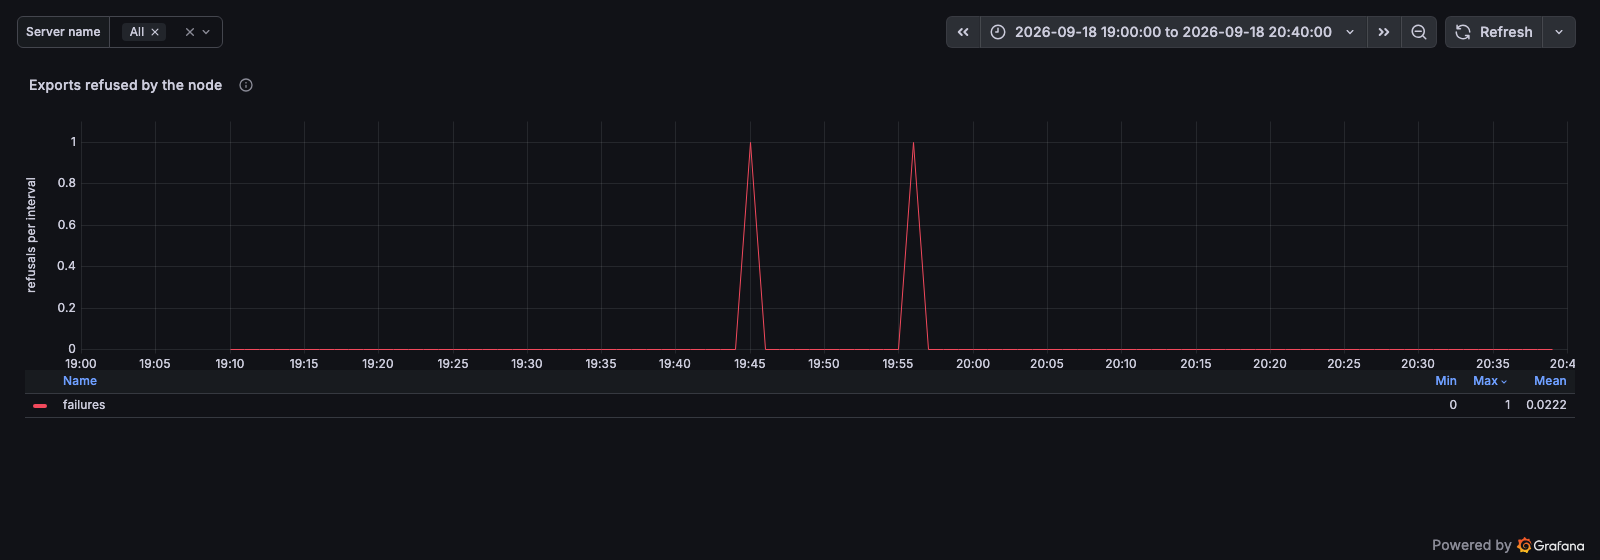
Некорректный запрос клиента в статистику не попадает: превышение потолка длительности, неизвестная дорожка, окно, уже стёртое чистильщиком. Это не отказ механизма. Разбор отказов по причинам доступен в выдаче самого сервера.
Сервер, на котором выгрузкой не пользовались, этих величин не присылает, поэтому пустой график означает отсутствие выгрузок за интервал, а не потерю данных.