Практикум: группа central в Docker
Резервирование объясняет, как устроена группа central, а Группа central на нескольких серверах — как её развернуть. Эта страница — про то, чтобы увидеть её работу своими глазами: на одной машине, из контейнеров, за десять минут и без единого арендованного сервера.
Стенд одноразовый. На нём можно и нужно делать то, чего не делают на работающей инсталляции: гасить процессы посреди работы и смотреть, что из этого выйдет.
Что понадобится
- Docker с compose — больше ничего ставить не нужно.
- Ключ лицензии. Он нужен каждому процессу: и обоим central, и всем трём стримерам.
- Свободные порты 8081 и 8082 на локальной машине.
Из чего собран стенд
Шесть контейнеров:
- postgres — одна база на всю группу.
- central-a и central-b — два инстанса управления над этой базой, консоли на портах 8081 и 8082.
- streamer-1 и streamer-2 — два стримера, разведённые по разным инстансам: первый ходит в central-a, второй — в central-b.
- streamer-3 — стример, которому назвали один адрес, central-b. О втором инстансе он может узнать только от самого central.
Разведение стримеров по инстансам — не украшение стенда, а его смысл. Картина «прямо сейчас» одна на всю группу, и весь парк обязан быть виден с любого из двух адресов, хотя отчитываются машины в разные. Третий стример — это положение любой машины существующего парка в день, когда к инсталляции добавили второй инстанс: переписывать конфиг на тысяче машин никто не будет.
Скачайте docker-compose.yaml и положите в пустой каталог. Ниже — те его куски, ради которых он написан; остальное в нём — обычная обвязка.
Первый инстанс заявляет все четыре роли, включая migrate:
central:
  admin_keys:
    - lab-admin-key
  components: {run: true, migrate: true, layouter: true, stats: true}
  advertise_url: http://central-a
Второй — то же самое без migrate: схему накатывает один процесс, иначе два погонят миграции наперегонки.
central:
  admin_keys:
    - lab-admin-key
  components: {run: true, migrate: false, layouter: true, stats: true}
  advertise_url: http://central-b
Роли layouter и stats заявлены у обоих, и это не двойной запуск: роль — притязание, а исполнителя выбирает мандат.
Стример получает не адрес инстанса, а список адресов группы; порядок — порядок предпочтения:
managed_by:
  name: streamer-1
  url:
    - http://central-a
    - http://central-b
  join_token: ${JOIN_TOKEN}
У второго стримера тот же список в обратном порядке. Третьему задан единственный адрес — тот, который практикум потом погасит:
managed_by:
  name: streamer-3
  url: http://central-b
  join_token: ${JOIN_TOKEN}
Стримеры собраны из того же образа, что и central: стример кластера Catena — это тот же бинарь Catena, и лицензия ему нужна та же.
Подъём
Стенд не собирается одним docker compose up: окно присоединения открывает живой central, и join-токен появляется только после его старта.
Сначала база и оба инстанса управления:
export CATENA_VERSION=latest
export LICENSE_KEY='ваш ключ'
docker compose up -d postgres central-a central-b
Дождитесь, пока консоль откроется на http://127.0.0.1:8081, и войдите как admin с паролем pass. При первом входе консоль попросит завести именную учётную запись — заведите.
Откройте Кластер → Стримеры, нажмите Разрешить присоединение и скопируйте join-токен. Поднимите стримеры с ним:
JOIN_TOKEN=jt-... docker compose up -d streamer-1 streamer-2 streamer-3
Все три машины появятся в списке стримеров за несколько секунд. Окно присоединения после этого закройте — парк собран.
Заведите несколько стримов, чтобы в кластере было что раскладывать. Вход syntetic — встроенный генератор, внешний источник стенду не нужен:
for i in 1 2 3 4 5 6; do
  curl -s -X PUT -H 'Authorization: Bearer lab-admin-key' \
    -H 'Content-Type: application/json' \
    -d '{"inputs":[{"syntetic":{}}]}' \
    "http://127.0.0.1:8081/central/api-v4/streams/configs/cam$i"
done
Группа целиком
Откройте Кластер → Central.
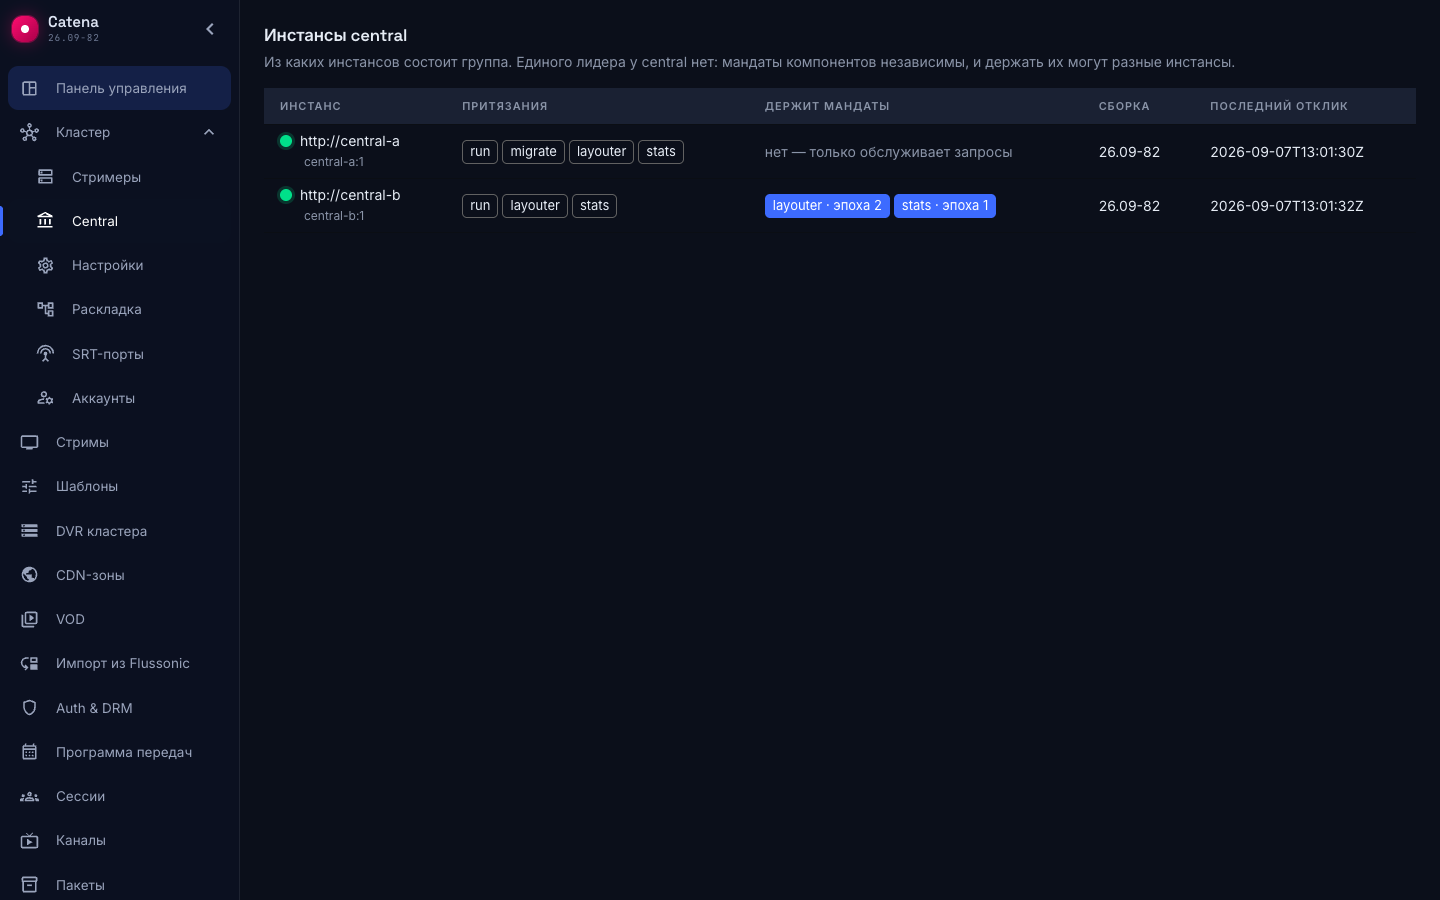
В таблице две строки — вся группа, и её одинаково показывает любой инстанс: реестр лежит в общей базе.
- Притязания у обоих почти одинаковы:
migrateзаявлен только уcentral-a, всё остальное — у обеих машин. - Держит мандаты заполнено только у одной. Это и есть ответ на вопрос «кто в группе главный»: главного нет, есть держатели отдельных мандатов.
- У второй строки написано нет — только обслуживает запросы. Такой инстанс не запасной и не спящий: он полноценно отвечает консоли, API и стримерам, просто фоновую работу сейчас делает не он.
На вашем стенде мандаты могут лежать иначе — оба у одной машины или по одному у каждой. Мандаты независимы, и их расстановка зависит от того, кто успел первым; неправильной расстановки здесь не бывает.
Парк виден с любого адреса
Не уходя с инстанса, откройте Кластер → Стримеры.
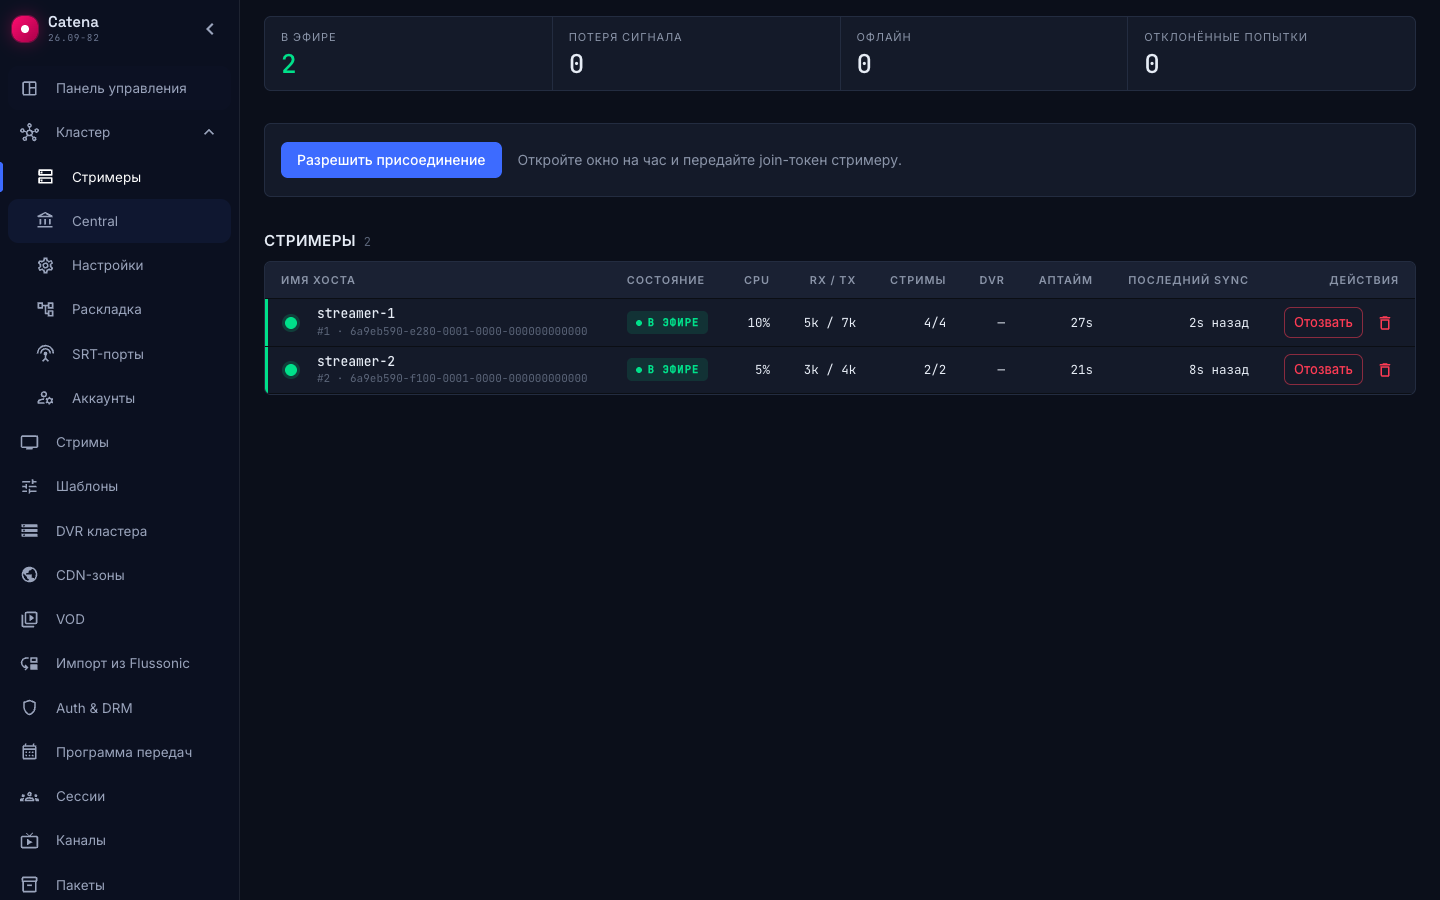
Все три машины в эфире, хотя отчитывается в этот инстанс только одна из них. Остальные шлют синхронизацию соседу, а видны здесь потому, что картина «прямо сейчас» одна на группу: инстанс без мандата stats ходит к ней по сети — по тому самому объявленному адресу.
Откройте ту же страницу на http://127.0.0.1:8082 — увидите то же самое. Это и есть проверка, ради которой стримеры разведены по разным инстансам.
Гасим держателя мандата
Теперь то, ради чего стенд одноразовый. Погасите инстанс, который держит мандаты, — на снимках выше это central-b:
docker compose stop central-b
Вернитесь на Кластер → Central живого инстанса и подождите несколько секунд.
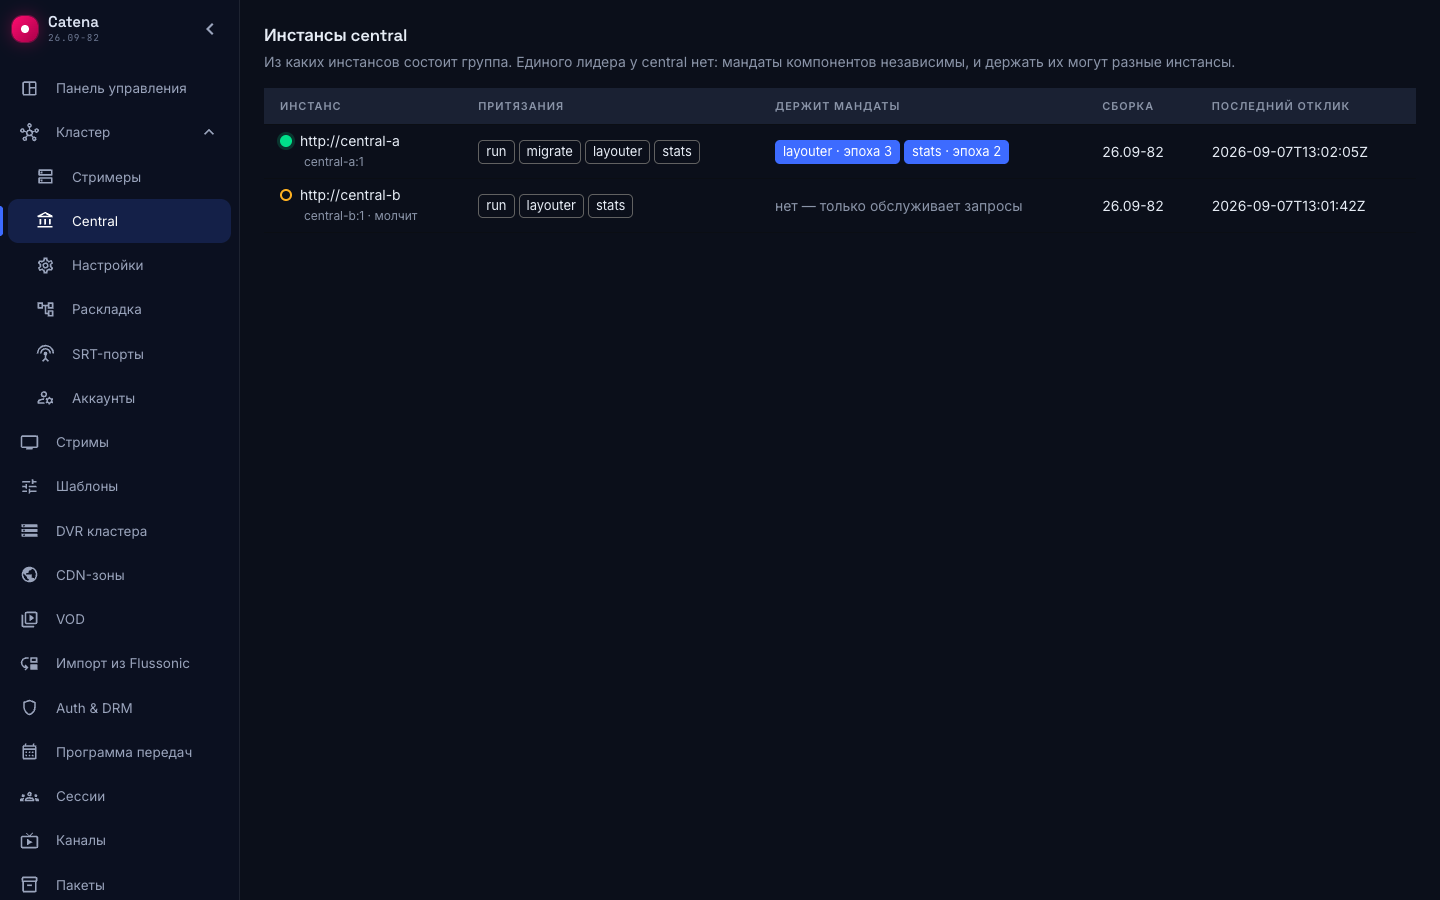
Три вещи изменились:
- Строка погашенного инстанса не исчезла, а помечена: «молчит — процесс, скорее всего, умер». Группа помнит свой состав, а не только живых.
- Мандаты перешли к живому инстансу. Никто их не передавал: мандат живёт на отдельном соединении с PostgreSQL и освобождается вместе со смертью сессии, а сосед приходит за освободившимся сам.
- Номер эпохи вырос. Он растёт при каждой смене держателя и едет вместе с каждой записью: инстанс, очнувшийся уже не держателем, получит отказ на записи, а не испортит размещение задним числом.
Переезд занимает секунды. Руками подтверждать его не нужно и нечем.
Стример, знавший один адрес
Откройте Кластер → Стримеры — по-прежнему на живом инстансе.
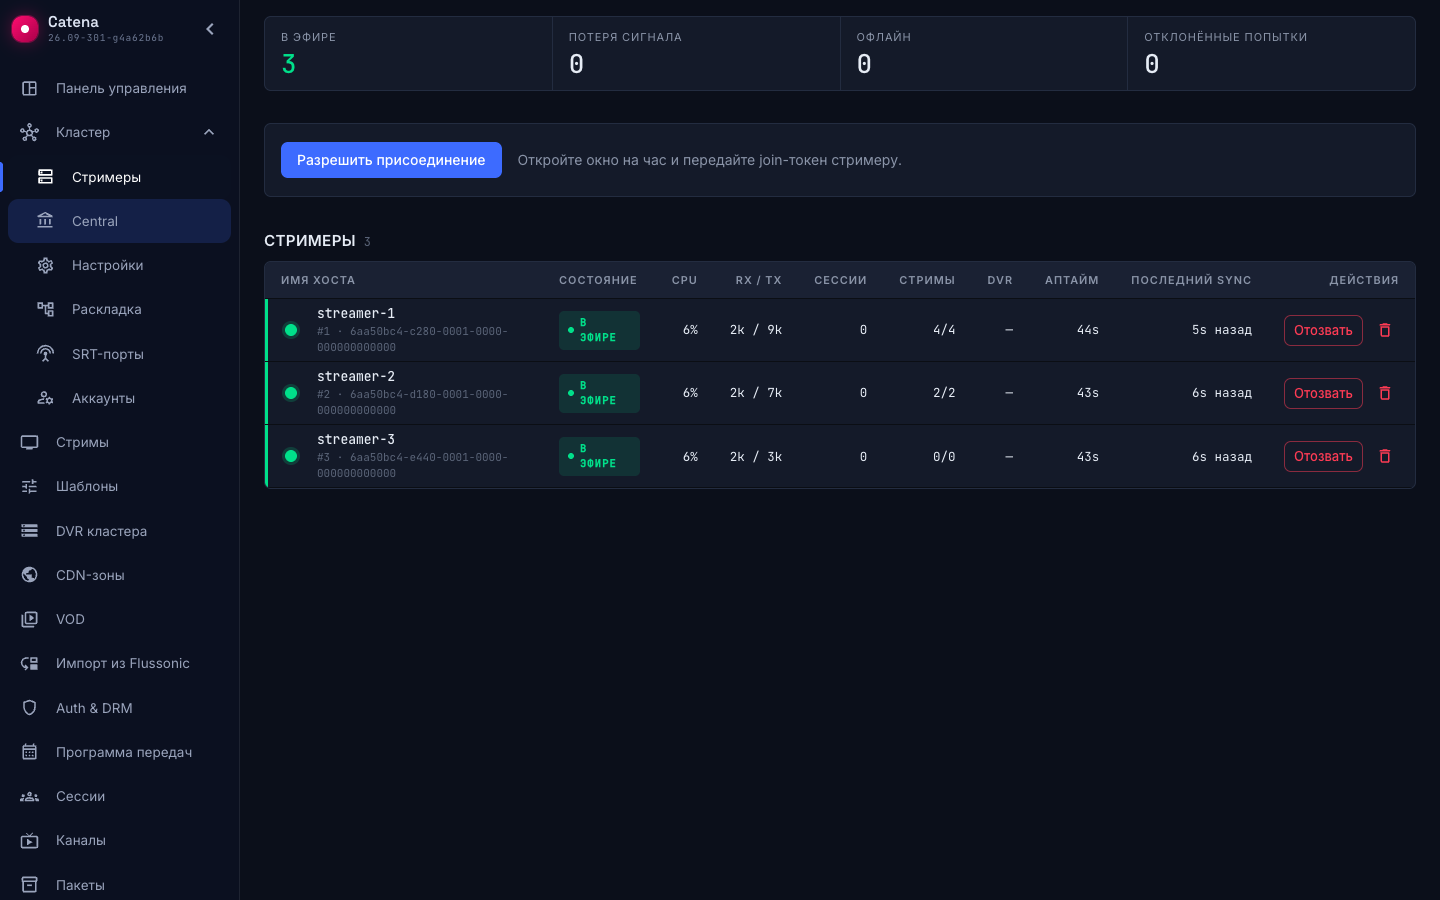
Все три машины в эфире, и третья среди них — та, которой в конфиге назван только что погашенный central-b. Второго адреса она из конфига не знала и всё равно ушла на него за один неудавшийся запрос: central даже не успел счесть её пропавшей.
Адрес она узнала от самого central. Каждый ответ на синхронизацию несёт состав группы — адреса живых инстансов, обслуживающих стримеры, — и стример дописывает их к тем, что заданы ему в конфиге. Выученное лежит на диске рядом с остальным состоянием машины, поэтому переживает её перезапуск:
docker compose cp streamer-3:/var/lib/catena/group.json group.json && cat group.json
{
  "announced": [
    "http://central-a"
  ]
}
В логе стримера этот момент отмечен строкой the central group roster changed — адреса из конфига в ней идут первыми, выученные следом. Переключение — строка switching to the next central address.
Проверьте и перезапуск: docker compose restart streamer-3 при погашенном central-b поднимает стримы из кэша, не дожидаясь сети, и за один неудавшийся запрос к central-b уводит машину на central-a — адрес прочитан с диска, хотя из конфига о втором инстансе она не знает.
Чего анонс не заменяет — первого ответа. Стример, который ещё ни разу не синхронизировался и потерял свой единственный адрес, о группе не знает ничего: через полторы минуты он числится offline, и лейаутер уводит его стримы на другие машины. Поэтому машины, которыми парк поднимается с нуля, получают оба адреса, а анонс закрывает всё остальное — добавление инстансов к уже работающему парку.
Эфир этого не заметил
Откройте Стримы.
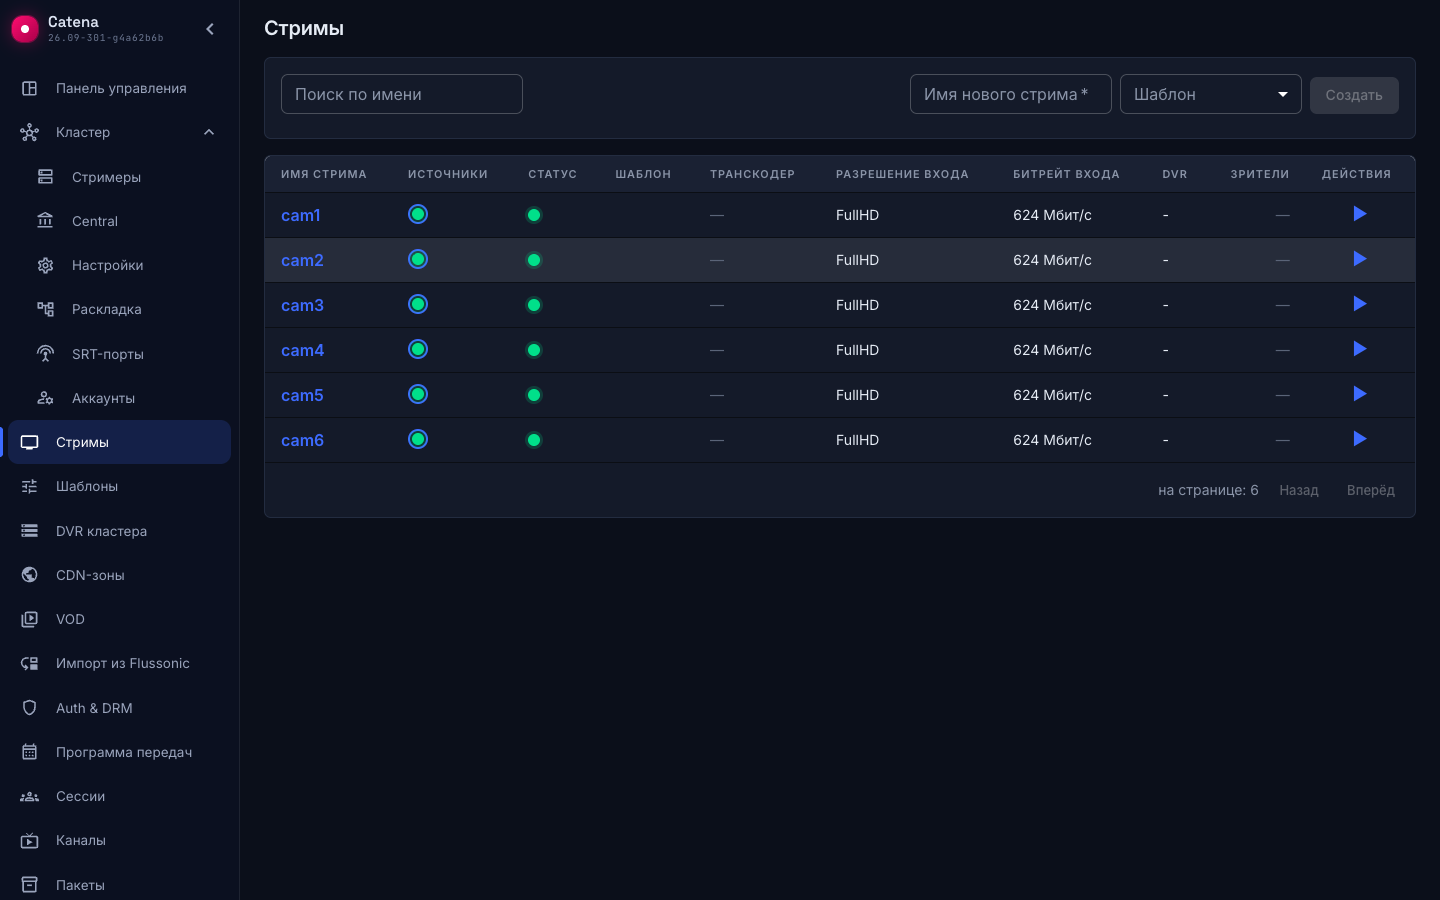
Все шесть стримов идут. Те, что живут на стримерах, отчитывавшихся в погашенный инстанс, переезда не заметили: смена адреса управления — не событие для эфира.
Возвращаем инстанс
docker compose start central-b
Строка снова загорается. Обратного переезда мандатов не происходит — и это не недоделка, а решение: отбирать их незачем, держатель работает, а смена держателя стоит новой инкарнации картины «прямо сейчас».
Стримеры же возвращаются. Раз в пять минут стример пробует первый адрес своего списка обычным запросом синхронизации: central-b ответил — streamer-2 и streamer-3 снова ходят к нему, потому что порядок в списке — предпочтение оператора, а не стартовая подсказка. Подождите пять минут и посмотрите лог:
docker compose logs --since 6m streamer-2 | grep -i 'preferred'
Успешный возврат отмечен строкой trying the preferred central address again без продолжения; будь адрес всё ещё мёртв, за ней шла бы the preferred address is still down, и стример остался бы там, где был.
Вернуть исходную расстановку мандатов можно перезапуском — стенд для того и одноразовый, — но в бою этого не требуется: группа работает в любой расстановке.
Убираем стенд
docker compose down -v
Ключ -v сносит и тома: база, состояние стримеров, их идентичность в кластере и выученные адреса группы. Без него следующий подъём получит наполовину чужое состояние.
Чего этот стенд не показывает
- Отказ базы. Здесь она одна и без реплики: погасите её — и управление встанет целиком, а эфир продолжится. Это правда, но резервирование базы — задача самой базы.
- Сеть. Все контейнеры в одной docker-сети, потерь и задержек между ними нет.
- Нагрузку. Шесть синтетических стримов не говорят ничего о том, как группа ведёт себя на настоящем парке.
- Точку входа оператора. На стенде их две — по адресу на инстанс; в бою нужен один адрес с переключением.