Резервирование
Автономия стримера позволяет продолжать вещание и запись архива при отказе central. Резервирование сохраняет доступность управления, пока отказавшую машину восстанавливают.
Эта страница — про то, из чего состоит инсталляция с резервом, сколько инстансов каждого компонента запускать и что именно меняет второй. Как это развернуть — Группа central на нескольких серверах. Карта состояния и гарантий — Компоненты и надёжность.
Что резервируется, а что нет
Резервировать нужно только управляющий контур. Путь медиа от него уже не зависит: стример забирает источник, транскодирует, пишет архив и отдаёт поток сам, а просмотр по публичному адресу стримера не требует проксирования медиа через central.
Отсюда правило, с которого начинается любая инсталляция с резервом: central и стримеры работают на разных машинах. Локальный стример внутри процесса central для такой инсталляции не годится — его стримы останавливаются вместе с процессом central.
Мандат: кто из инстансов делает работу
Несколько инстансов central над одной базой — это группа. Часть работы в ней безвредно делать всем сразу, а часть — нет: два лейаутера могут одновременно менять размещение одних и тех же стримов.
Такую работу в группе делает один инстанс — тот, который взял на неё мандат. Три свойства мандата определяют всё поведение группы при отказе.
- Мандат выдаёт PostgreSQL, а не конфиг. В конфиге инстанса стоит только притязание — «эта машина готова делать такую работу». Компонент включают на нескольких инстансах, чтобы работу мог продолжить другой.
- Мандат освобождается после завершения соединения с базой. Он удерживается отдельным соединением с базой: сессия завершается, мандат освобождается, и его получает другой инстанс. Ни таймаутов, ни разбора зависших исполнителей, ни ручного подтверждения.
- У каждой выдачи есть номер — эпоха. Она растёт при смене держателя и проверяется при каждой записи. Инстанс, продолживший работу после утраты мандата, получает отказ на записи, а не портит размещение задним числом.
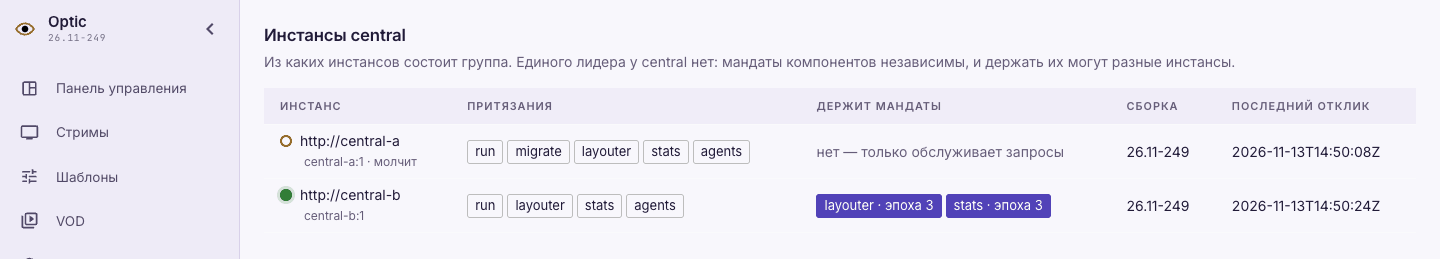
Мандатов несколько, и они независимы. Единого лидера у central нет: размещение и статистику могут обрабатывать разные инстансы, и это штатное состояние.
Кто что держит, видно в консоли: Кластер → Central.
Компоненты и их количество
Central — не один процесс с одной ролью, а несколько разных работ, и резервируются они по-разному.
| Компонент | Сколько исполнителей | Что даёт второй инстанс |
|---|---|---|
| PostgreSQL | Один кластер | Резервируется средствами самой базы, не Optic |
| Обработчики запросов | Все инстансы | Управление переживает потерю машины |
| Подключения агентов | Все инстансы с компонентом agents |
Агент переподключается к доступному central по прежнему URL |
| Текущее состояние | Держатель мандата stats |
Замену держателя; статистика собирается заново |
| Лейаутер | Держатель мандата layouter |
Замену исполнителя без вмешательства оператора |
| Миграции схемы | Ровно один инстанс | Ничего: два мигратора — гонка, см. ниже |
| Забор сессий со стримеров | По исполнителю на стример | Стримеры упавшего инстанса переходят к работающему |
| Периодические работы | Во всех | Ничего: дело всё равно делает кто-то один |
| Точка входа оператора | Один адрес | — |
| Стримеры | Сколько требует эфир | Резервируются не здесь, а размещением |
Дальше — что каждый из них делает и почему количество именно такое.
Обработчики запросов
Это то, что оператор и кластер видят как central: консоль, management API, обработчики проигрывания, выдача метрик и приём синхронизации от стримеров. Состояния у обработчика своего нет — всё лежит в PostgreSQL, — поэтому инстансов может быть сколько угодно, и на запрос оператора отвечает любой.
Стримеру, однако, нужен не балансировщик, распределяющий запросы по группе, а список адресов: он ходит на первый, переходит к следующему после неудавшегося запроса и возвращается на первый, когда тот снова отвечает. Начало списка задаётся в конфиге стримера, остальное он узнаёт от самого central: каждый ответ на синхронизацию несёт состав группы, так что третий инстанс не требует правки конфигов на стримерах — см. Стример узнаёт группу сам.
Второй инстанс даёт две вещи:
- Управление переживает потерю машины. Оператор и стримеры переходят на доступный инстанс.
- Обновление без окна простоя. Инстансы обновляются по очереди.
Подключения агентов
Каждый central с компонентом agents принимает endpoint-соединения и обрабатывает их в своём процессе. У агента один URL; DNS-имя этого URL указывает на несколько central. При отказе подключения или endpoint-протокола агент пробует другой IP, сохраняя URL. Работающее соединение сохраняется на принявшем его инстансе.
Команду агенту можно отправить через любой central: запрос поступит на инстанс с его соединением. Медиатуннель streampoint соединяет агента с назначенным стримером. Первичная настройка endpoint и streampoint описана в приёме видео через агентов.
Настройки адресов и проверка переключения — в группе central.
Текущее состояние
То, что консоль показывает про «прямо сейчас» — какие стримы идут, сколько подключений просмотра, — central не читает из базы. В базе лежит то, что должно быть (настройки, размещение) и что уже случилось (закрытые сессии, журналы), а текущее состояние хранится в памяти.
Сведения о текущем состоянии общие для группы; их хранит держатель мандата stats. Остальные инстансы обращаются к держателю по сети — по адресу, который держатель объявил о себе. Поэтому все стримеры видны с любого адреса группы, хотя стримеры отчитываются в разные инстансы.
Отсюда единственное, что оператору нужно знать про смену держателя: статистика не переносится, а собирается заново — из ближайших синхронизаций, за секунды. В это окно консоль показывает неполные цифры: стрим уже вещает, но в списке активных ещё не появился.
Потерять при этом нечего — ни архив, ни учёт сессий, ни настройки: неполны только сведения о текущем состоянии. Практическое правило: первые полминуты после смены держателя — не показание о состоянии кластера, и тревога о «пропавших стримах» в этом окне связана с восстановлением статистики.
Лейаутер
Лейаутер решает, какой стрим на какой машине идёт. Дубль этой работы вреден: два лейаутера над одной базой принимали бы решения одновременно и писали в журнал размещения — стримы переносились бы между машинами без причины.
Поэтому прогоны исполняет держатель мандата layouter, а его записи ограждены эпохой выдачи. Роль layouter при этом заявляют все инстансы группы: заявить её у одного значит остаться без размещения, когда именно эта машина умрёт.
Инстанс, не держащий мандата, полноценен во всём остальном: он обслуживает консоль, API и синхронизацию стримеров. Ничего включать при аварии не нужно — мандат переходит сам.
Миграции схемы
Единственная работа, которую мандат не защищает, — накат миграций при старте. Два процесса, стартовавшие одновременно, погонят их наперегонки, поэтому роль migrate заявляет ровно один инстанс, а остальные стартуют после него.
Оговорка важнее, чем кажется: пустой объект central.components сохраняет значения предыдущих слоёв. Если migrate нигде не задан, он включён по умолчанию. Второй инстанс, поднятый копией конфига первого, окажется вторым мигратором.
Забор сессий со стримеров
Кто и что смотрел — сессии — central не получает пассивно: он сам постоянно получает их со стримеров, по непрерывному каналу на каждый стример.
Работа делится по стримерам: данные одного стримера в любой момент получает один исполнитель, разные стримеры могут обслуживаться разными исполнителями. После отказа инстанса данные его стримеров получает другой; учёт сессий сохраняется.
Простой тоже не теряет записей: стример держит журнал сессий у себя несколько суток, и забор продолжается с того места, где прервался. Часовой простой означает, что записи приедут позже, а не что их не будет.
Периодические работы
Остальное фоновое — работы по расписанию: чистка журналов по срокам хранения, учёт хранилищ VOD (гашение хранилищ пропавших машин, истечение незавершённых загрузок), снятие статуса с замолчавших стримеров.
Они выполняются во всех инстансах: повторное выполнение чистки и учёта хранилищ не меняет результат.
Разносить эти работы по инстансам руками не нужно, выключать где-либо — тоже.
PostgreSQL
База — хранилище конфигурации и реестров и единственная точка, резервирование которой Optic не берёт на себя. Нужен один логический кластер, доступный всем инстансам по одному адресу, а его собственная отказоустойчивость — задача самой базы: реплика с переключением или управляемый инстанс провайдера.
Два независимых сервера базы — не резервирование, а две разные инсталляции: у них разойдутся и размещение, и реестр стримеров.
Бэкап нужен по-прежнему: резерв защищает от потери машины, но не от ошибочного удаления — см. Бэкап и восстановление.
Точка входа оператора
Оператору нужен один адрес, который сам находит доступный инстанс: DNS-имя с переключением или балансировщик перед группой.
Стримеры через него не ходят — у них свой список адресов, и лишний посредник на пути синхронизации только добавит точку отказа.
Стримеры
Стримеры резервируются не количеством инстансов управления, а размещением: стрим, которому задано больше одной машины, переживает потерю любой из них. Это отдельная от central тема.
Сценарии
Отказ инстанса
Всё происходит само, без вмешательства.
- Стримеры переключаются на следующий адрес своего списка за один неудавшийся запрос. Перенастраивать их не нужно, и перерыва в вещании нет.
- Мандаты отказавшего инстанса переходят к работающему за секунды. Размещение продолжает работать, новые стримы размещаются как обычно.
- Статистика собирается заново. Полминуты цифры в консоли неполны — статистика восстанавливается.
- Оператор работает через тот же адрес и тем же паролем. Состояние лежит в базе, а не в потерянной машине: реестр стримеров, настройки, размещение — на месте.
Единственное, чего авария касается по-настоящему, — накат миграций: если отказал инстанс с ролью migrate, её на время восстановления берёт на себя другой, иначе следующее обновление не с чего будет начать.
Возврат инстанса
Возврат — не аварийная операция и окна простоя не требует.
- Мандаты остаются у того, кто их держит. Исправный держатель продолжает работу; повторная смена держателя потребовала бы заново собрать статистику.
- Стримеры возобновляют синхронизацию с предпочтительным адресом — в пределах пяти минут, обычным запросом синхронизации. Порядок в их списке — предпочтение оператора, и оно восстанавливается само.
Группа работает в любой расстановке мандатов, поэтому возвращать её к исходной не требуется.
Плановое обновление
Инстансы обновляют по очереди, и это тот же сценарий, только управляемый: пока обновляется один, стримеры работают со вторым. Мандаты при этом переходят дважды — по разу на каждый перезапуск, — и оба раза сами.
Потеря базы
Управление останавливается целиком: инстансов может быть сколько угодно, но состояние у них одно. Пока база недоступна, консоль и API не обслуживают запросы, новые стримы не заводятся и не размещаются. Мандатов в это время не держит никто — их выдаёт база.
Эфир при этом продолжается: стримеры автономны — вещают, пишут архив и раздают видео, не спрашивая central. Поэтому потеря базы — это простой управления, а не эфира.
Восстановление — средствами самой базы (переключение на реплику) или из бэкапа; см. Бэкап и восстановление.