Распознавание речи
Телетекст и кэпшны станция не сочиняет: она провозит текст, который принесла с собой картинка. Но канал, у которого текста нет вовсе, от этого субтитров не получает — а именно его чаще всего и нужно снабдить ими: региональная врезка, корпоративная трансляция, чужой источник без служебных данных.
Распознавание речи закрывает этот случай: станция сама читает звук записанного канала и дописывает к нему субтитровую дорожку.
Живой сигнал при этом не трогается вовсе. Распознавание работает поверх архива: читает записанный звук и туда же кладёт субтитры. Отсюда два следствия, о которых стоит знать заранее.
- Каналу обязательна запись архива. Без неё распознаванию неоткуда брать звук и некуда писать результат.
- Отставание безопасно. Если распознавание не поспевает за эфиром, субтитры отстают и потом догоняют; на выдаче канала это не сказывается никак.
Как включить
Распознавание живёт на вкладке Обработка карточки канала, в секции Распознавание речи. Включает его переключатель Распознавать речь в субтитры.
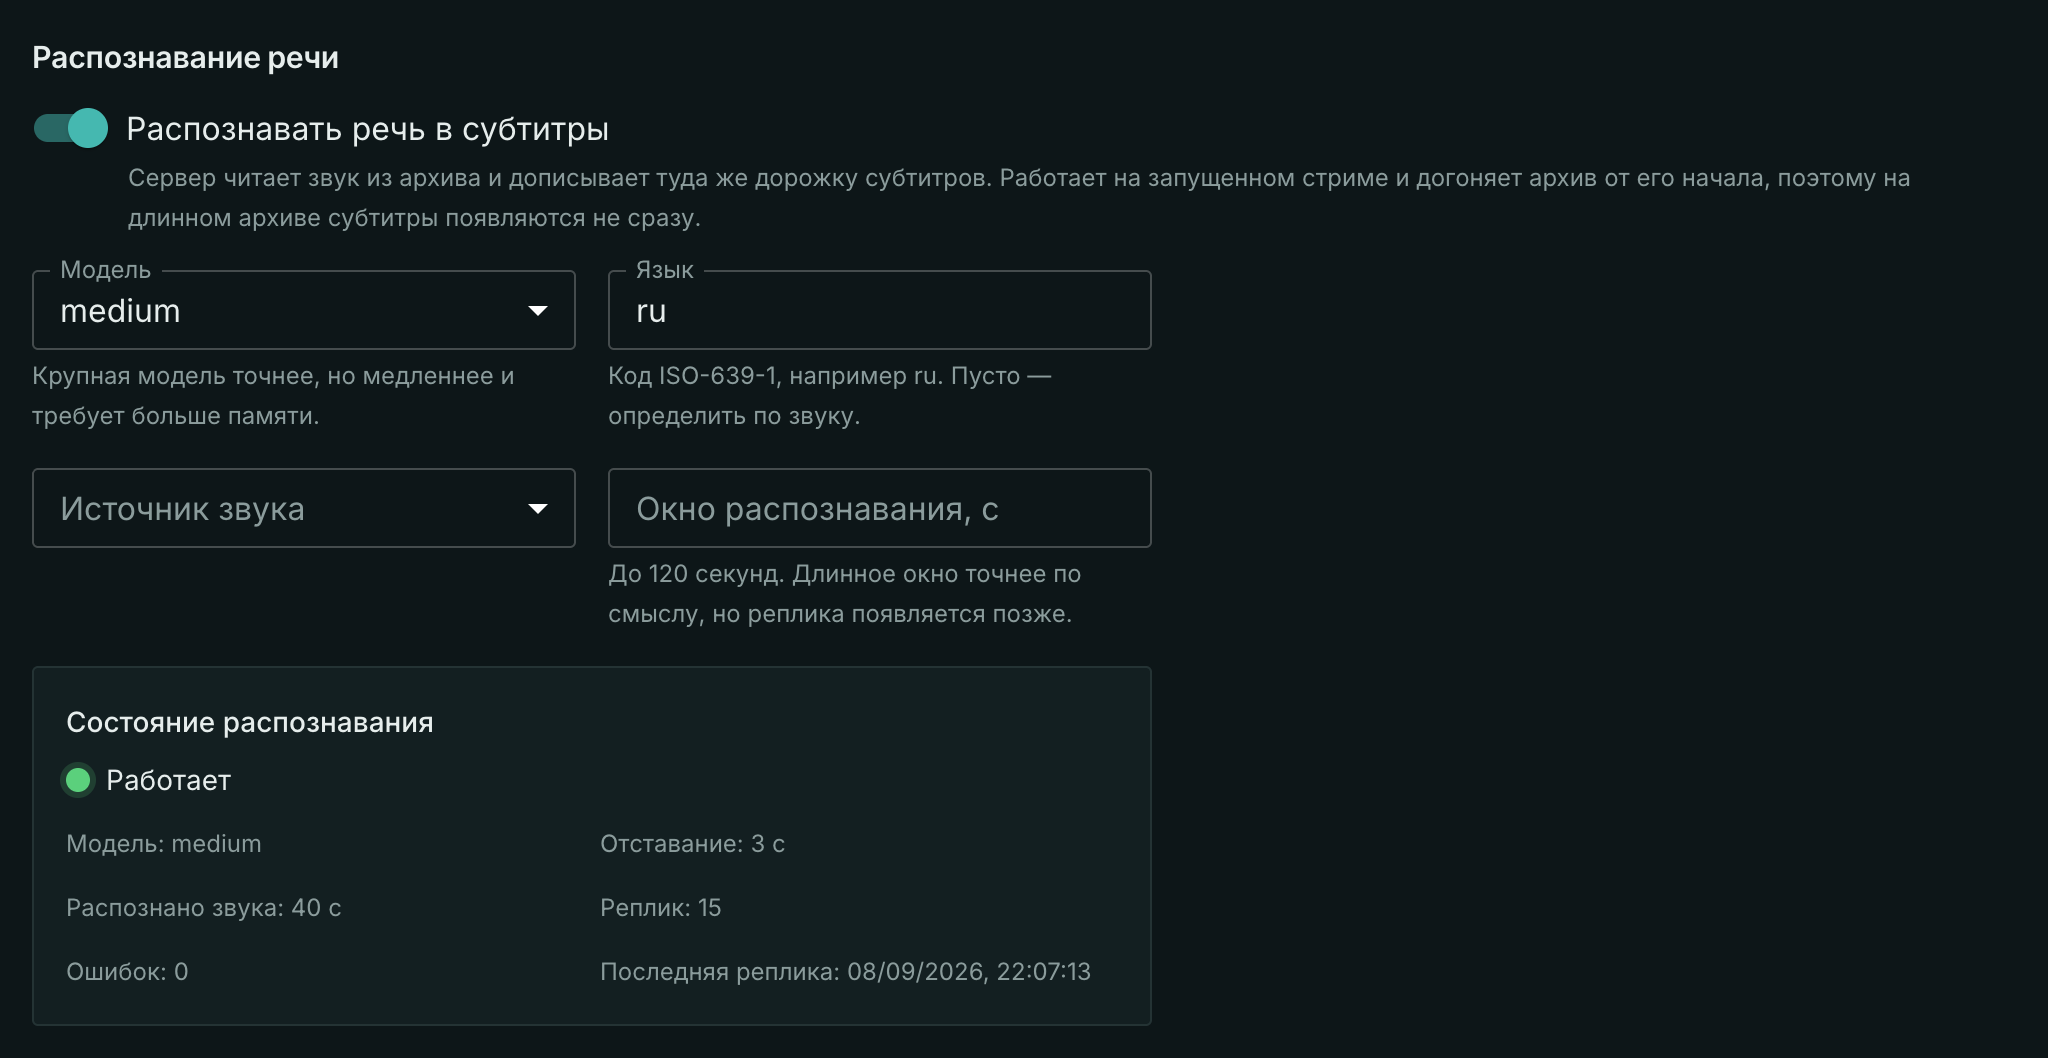
Полей четыре, и все они не обязательны — умолчаний хватает, чтобы включить распознавание одним переключателем.
| Поле | Что задаёт |
|---|---|
| Модель | Размер распознавателя. Крупная модель точнее, но медленнее и требует больше памяти. |
| Язык | Код ISO-639-1, например ru. Пусто — определить по звуку. |
| Источник звука | Дорожка эфира, которую слушать. По умолчанию первая. |
| Окно распознавания, с | До 120 секунд. Длинное окно точнее по смыслу, но реплика появляется позже. |
Язык лучше задать, если он известен. Автоопределение решает по первым секундам звука и на канале, который начинается с музыкальной заставки, ошибается — а ошибка в языке портит всю дорожку, а не одну реплику.
Источник звука — обычное дело на головной станции: канал везёт несколько языковых дорожек, а распознавание слушает ровно одну. Если выбранной дорожки в эфире нет, состояние так и скажет — «Выбранная аудиодорожка в эфире не найдена».
Без записи архива не запускается
Если включить распознавание на канале без записи, панель отвечает сразу, не дожидаясь сохранения:
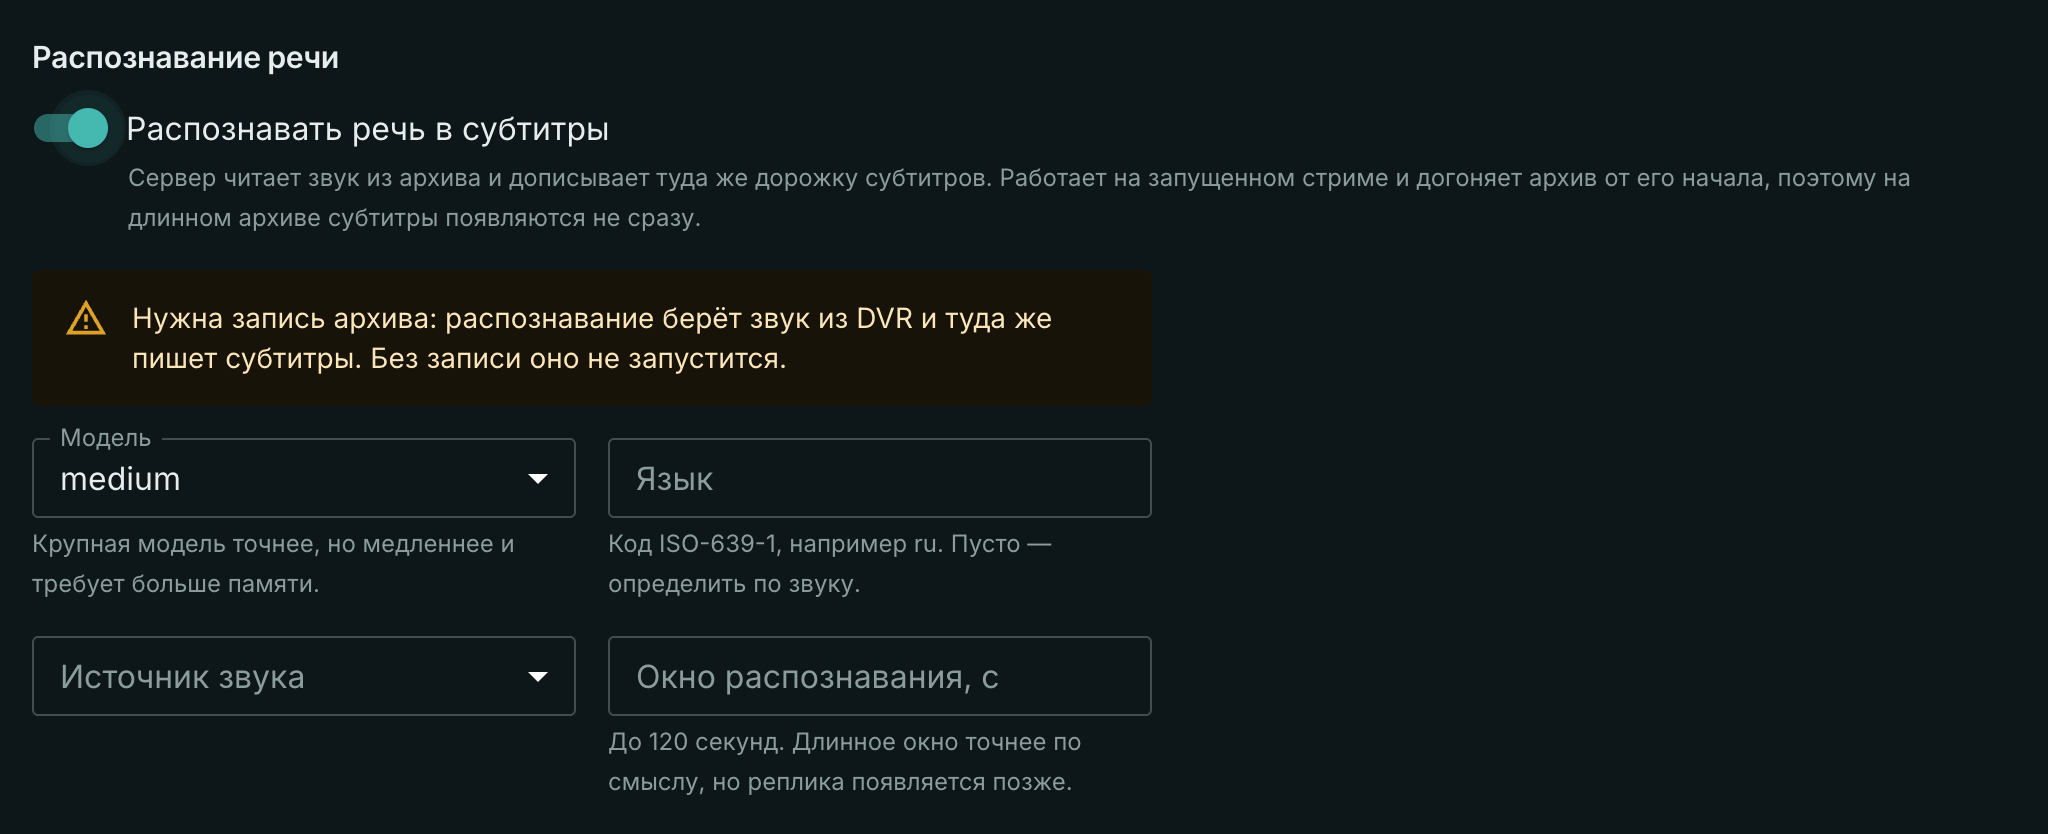
Это не запрет сохранить настройку, а предупреждение о том, что она не заработает. Включите каналу запись, и распознавание поднимется само.
Состояние распознавания
Под формой панель показывает, что происходит на самом деле. Это единственное место, где видна живая работа распознавания: карточка канала берёт состояние с той ноды, где канал записывается.
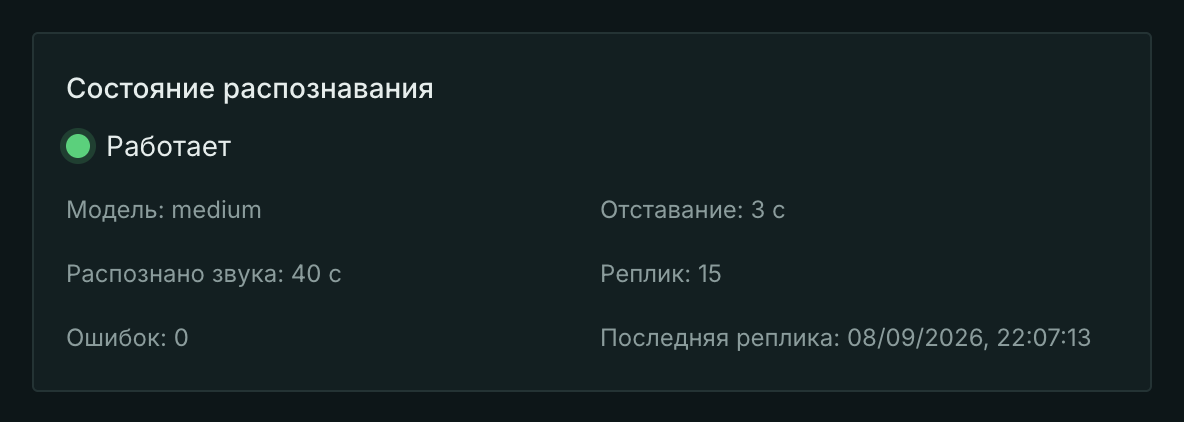
- Работает / Не работает — поднято ли распознавание. «Не работает» всегда сопровождается причиной текстом.
- Отставание — на сколько распознанное отстаёт от текущего момента. На живом краю это секунды; на архиве, который распознавание догоняет с начала, — часы, и это нормальный рабочий режим, а не сбой.
- Распознано звука — сколько звука уже прошло через распознаватель.
- Реплик — сколько строк субтитров написано.
- Ошибок — сбои чтения архива и распознавания. Ноль здесь — обычное состояние.
- Последняя реплика — когда распознавание в последний раз что-то написало.
Причины, по которым распознавание не поднимается, панель называет прямо:
| Что написано | Что делать |
|---|---|
| У стрима нет записи архива | Включить запись. |
| Файл модели не найден или не загрузился | Положить файл модели на сервер (ниже). |
| Выбранная аудиодорожка в эфире не найдена | Выбрать другой источник звука или оставить умолчание. |
| Такой язык распознавателю неизвестен | Проверить код языка или очистить поле. |
| Сборка сервера без распознавания речи | Обратиться в поддержку: коробка собрана без движка. |
Работающее распознавание со свежей ошибкой — это предупреждение, а не авария: один непрочитанный кусок не останавливает работу, распознавание продолжается со следующего.
Файл модели
Сама модель на сервер не поставляется: пригодная весит больше гигабайта, и какая нужна — решает владелец станции. Сервер ищет её в каталоге состояния продукта — /var/lib/mcaster/whisper-models — и ждёт там файла ggml-<модель>.bin, то есть ggml-medium.bin для модели medium.
Пока файла нет, состояние распознавания честно говорит «Файл модели не найден или не загрузился», а канал продолжает работать и записываться как ни в чём не бывало.
Один файл обслуживает все каналы станции: модель читается в память один раз на процесс, сколько бы каналов её ни просило.
Что уходит на выход
Распознанное становится обычной субтитровой дорожкой канала: она видна в медиаинформации и уезжает в OTT-копию как WebVTT — ровно там, где текстовая дорожка и нужна, потому что телетекст ни один OTT-плеер не декодирует.
В транспортном потоке распознанного текста не будет: субтитровой дорожке внутри MPEG-TS ехать не в чем — то же ограничение, что и у извлечения телетекста.
Смотреть дорожку имеет смысл по архиву. На живом краю субтитров ещё нет — они появляются с тем самым отставанием, которое показывает состояние.
Что дальше
- Субтитры и телетекст — что делать с текстом, который канал уже везёт.
- Запись и чтение архива — без чего распознавание не запускается.
- OTT-копия — куда уезжает распознанная дорожка.